洞察
数据
先有指标,再谈模型
为什么第一个自动化项目,应该是那个没人愿意拿去演示的项目,以及后面的项目该怎么排序。
当一家企业决定“用 AI 做点什么”时,第一个被选中的项目通常最显眼:面向客户的智能助手、给董事会看的预测大屏、年会上一个惊艳的演示。这几乎总是错误的起点。
正确的第一个项目,是让之后每一个项目都可以被衡量的那个。它很少令人兴奋,通常只是一段“管道”:把一场关于“进展如何”的争论,变成一个所有人都认可的数字。
没定义清楚的东西,没法改进
设想一个团队希望用 AI 模型给进来的客服请求做分诊。显而易见的问题是用哪个模型。更好的问题是:我们现在怎么知道一个请求分诊得好不好?在大多数组织里,答案是没人知道。没有“正确”的共同定义,没有分诊之后发生了什么的记录,也没有今天要花多长时间的基线。
缺了这些,项目不可能成功,因为“成功”从未被定义,只能被宣布。而一个由建造者自己宣布成功的项目,财务总监不会第二次拨款。
不起眼的第一个项目
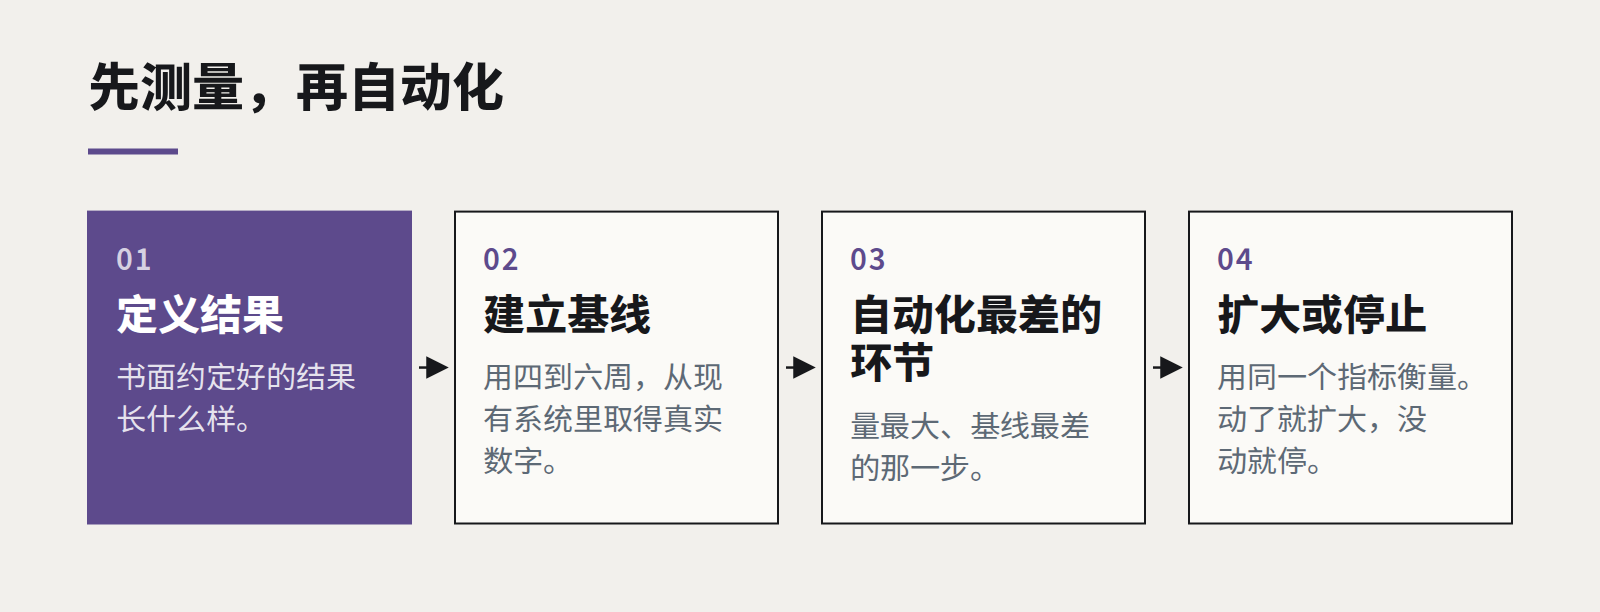
所以我们推荐的第一个项目,几乎总是一个度量项目。以客服为例,它意味着:
- 书面约定一个分诊良好的请求长什么样——进了正确的队列、定了正确的优先级、在规定时间内完成。
- 从现有系统中自动记录每个请求的这一结果。
- 每周发布基线:请求量、当前分诊的准确率、首次响应时间、返工率。
这通常需要四到六周。什么都没自动化,也没人拿到演示。但结束时,企业精确地知道了自己的起点——并且拥有一份带标注的历史请求数据,它同时就是日后评估任何模型的评测集。
后面的项目排在它后面
一旦指标存在,后续项目的顺序几乎自己就出来了:在基线最差、量最大的环节先做自动化;用同一个数字来衡量;数字动了就扩大,没动就停下——你损失的是几周,而不是一年。
这个顺序也改变了内部政治。关于 AI“有没有用”的争论,变成了关于一张图表的讨论,而后者要短得多。原本持怀疑态度的团队能在基线里看到自己的工作,并主动提出哪里最需要自动化。
好指标的共同点
- 衡量的是企业本来就在意的结果,而不是模型分数。
- 能从现有系统自动计算,不需要人工统计。
- 有一位技术团队之外的负责人。
- 在做出任何改变之前就已经开始测量。
最后一点最常被跳过,也最重要。一个在项目上线后才开始记录的指标,无法证明项目的任何价值。先测量,再动手。
继续阅读
全部洞察