洞察
技术栈
Postgres 是默认数据库,也理应如此
文档、搜索、队列、用于 AI 检索的向量——一个运行良好的 Postgres,如今就能覆盖过去需要四个产品才能完成的工作。再加一个数据库的理由,比以前少多了。
开始一个新系统时,数据库问题通常一句话就定了:用 Postgres,除非有具体理由不用。这句话一年比一年好写,因为“具体理由”的清单越来越短。
这不是品牌忠诚,而是对运维成本的判断。系统里每多一个数据存储,就多一样要备份、加固、监控、升级、并与其他存储保持一致的东西。对我们主要服务的这类规模的组织来说,最便宜的架构通常就是活动部件最少的那个,而 Postgres 已经悄悄接下了许多过去需要单独产品才能完成的工作。
一个数据库现在能做什么
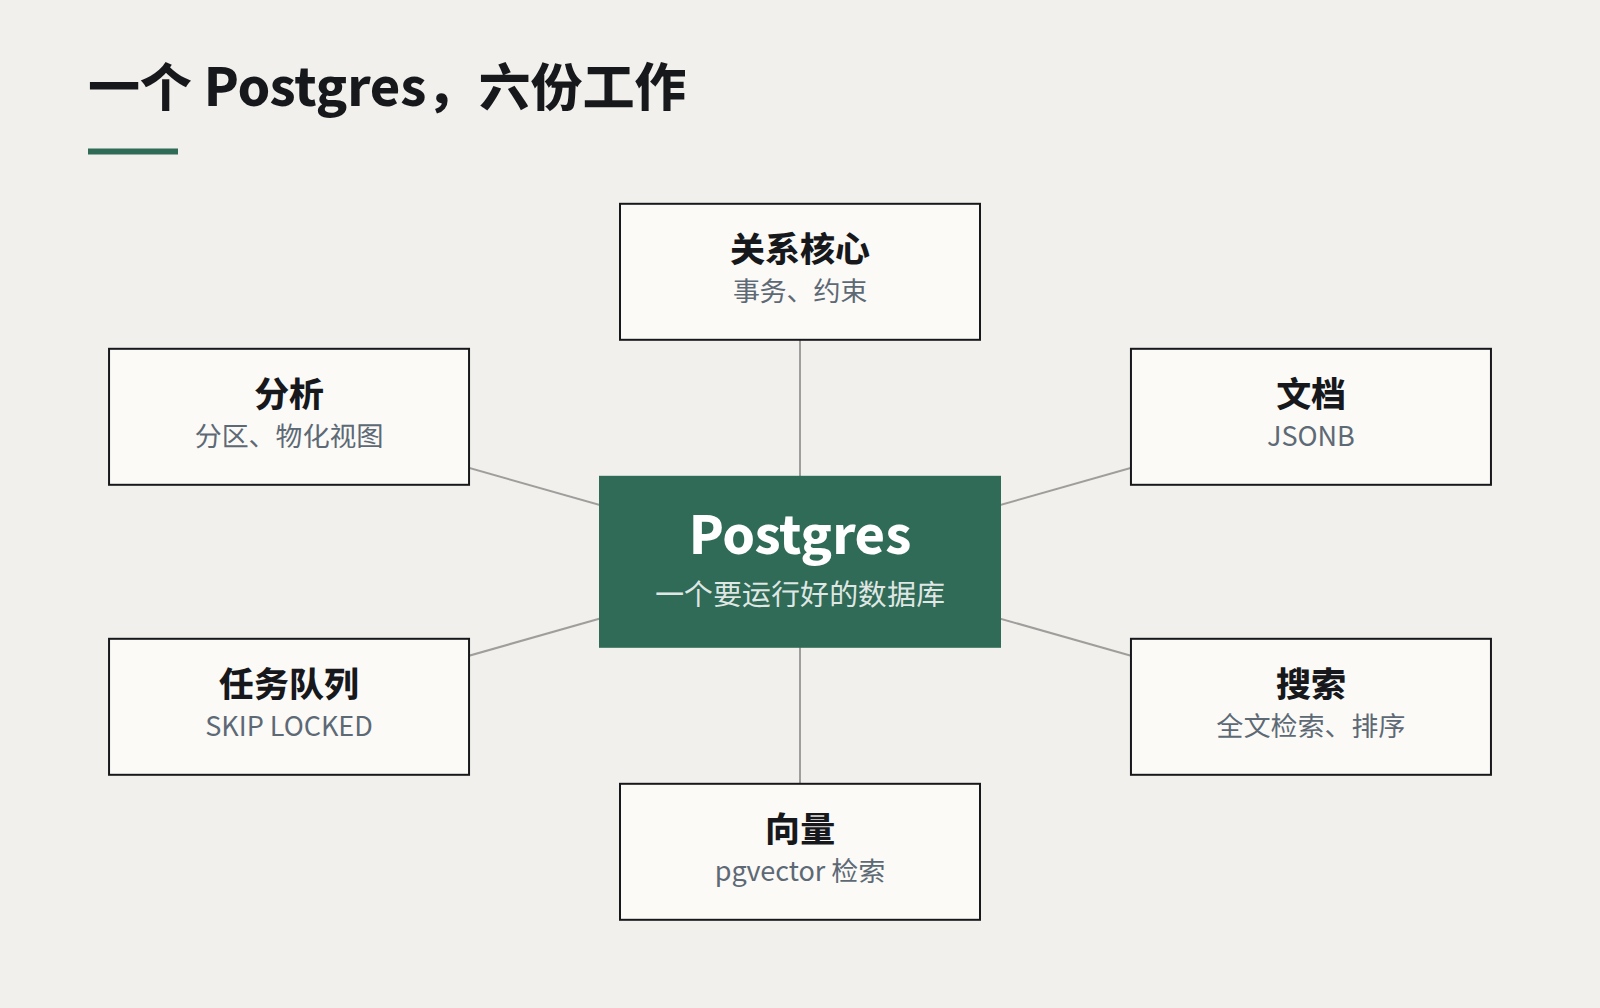
- 关系型数据,这是自然,有事务、约束和成熟的查询规划器,是其他一切的基础。
- 文档。 JSONB 列对半结构化数据的存储和索引已经足够好,很少有理由再单独上一个文档数据库。把结构化的核心放在列里,把可变部分放进 JSON。
- 搜索。 内置全文检索能处理大多数应用内搜索——产品目录、知识库、客服工单——支持排序和按语言的词干处理。
- 向量。 pgvector 扩展把嵌入向量存在它所描述的数据行旁边,并在那里做相似度搜索。对企业规模的 AI 检索来说,把向量和源记录放在一起,权限、关联和新鲜度都是白送的。
- 队列与任务。 一张配合
SKIP LOCKED的表,就是一个每分钟处理数千任务都游刃有余的任务队列,而且有一个巨大优势:入队这个动作,可以和触发它的数据变更处于同一个事务里。 - 中等规模的时序与分析,借助分区和物化视图。
为什么对 AI 工作更重要
当检索成为 AI 功能的核心,选择 Postgres 的理由变得更充分了。单独的向量数据库意味着要把数据从记录系统里复制出去、让两个存储保持同步、在第二个存储里重新实现一遍权限控制。向量放在 Postgres 里,一条检索查询就能在按相似度排序的同时,按租户、权限和日期过滤。删除一个客户的数据,他的向量也一并删除。
在超大规模下——数亿向量、严苛的延迟目标——专用引擎也许值得它的运维成本。大多数企业离那条线还差好几个数量级。
什么时候再加别的
只有当以下某一条成立、并且能被证明(而不是被预期)时,我们才会加第二个数据存储:
- 调优良好、配有只读副本的 Postgres,确实扛不住的读写量。
- 访问模式根本不同的负载,比如跨越数年事件的大规模分析,列式数仓要高效得多。
- 一个简单的内存缓存比数据库调优更便宜就能解决的缓存需求。
把它运行好
依赖单一数据库的另一面,是它必须被运行好。除非有充分理由,否则用托管服务。要测试恢复,而不只是测试备份。每周看一次慢查询。迁移脚本放进版本控制,像代码一样评审。一个运行良好的 Postgres,是现代软件里最可靠的组件之一;一个被忽视的 Postgres,则是单点故障。区别在于纪律,而不在于技术。
继续阅读
全部洞察